个人项目说明 · 独立开发 · 已上线收费
AuthrWrite.
给中文长篇小说作者的 AI 写作工作台,Windows 桌面 + Android。 AI 从不直接改正文,只提交候选稿;改哪一段、要不要改,由作者逐段点头。
客户端、服务端、支付、运营后台、服务器部署与备案,全部由我一个人完成并持续运营。
作者怕的不是 AI 写得差,
是 AI 改了正文却说不清改了什么。
让通用聊天框写 3000 字,真正耗人的不是生成,是接下来的比对:哪 12 处跟我原来的不一样、 哪一处删掉了我三天前埋的伏笔、哪一处把主角的口气改成了另一个人。 对一遍比写一遍还慢,而且一次手滑覆盖,稿子就回不来了。
所以这个产品的第一原则不是「生成得更像人」,而是一句更朴素的话: AI 不直接动正文。它只能提出修改;能不能落盘,是作者一下一下点出来的。
长篇作者每天产出有限,任何一次「整段重写」都在赌上下文没被改坏。
把「有没有改坏」的检查成本推给用户,作者越依赖 AI 越不敢信任 AI。
把不可逆的替换,降级成一份可以逐条否决的提案;每一版都留快照。
把 AI 的修改做成可被否决的提案,
把第一次上手压到 2 分钟。
这一节有四件事:候选稿机制、开书向导、统一状态层、快捷工具与渠道选择。 它们共同回答一个问题——作者凭什么敢让 AI 碰自己写了三个月的稿子。
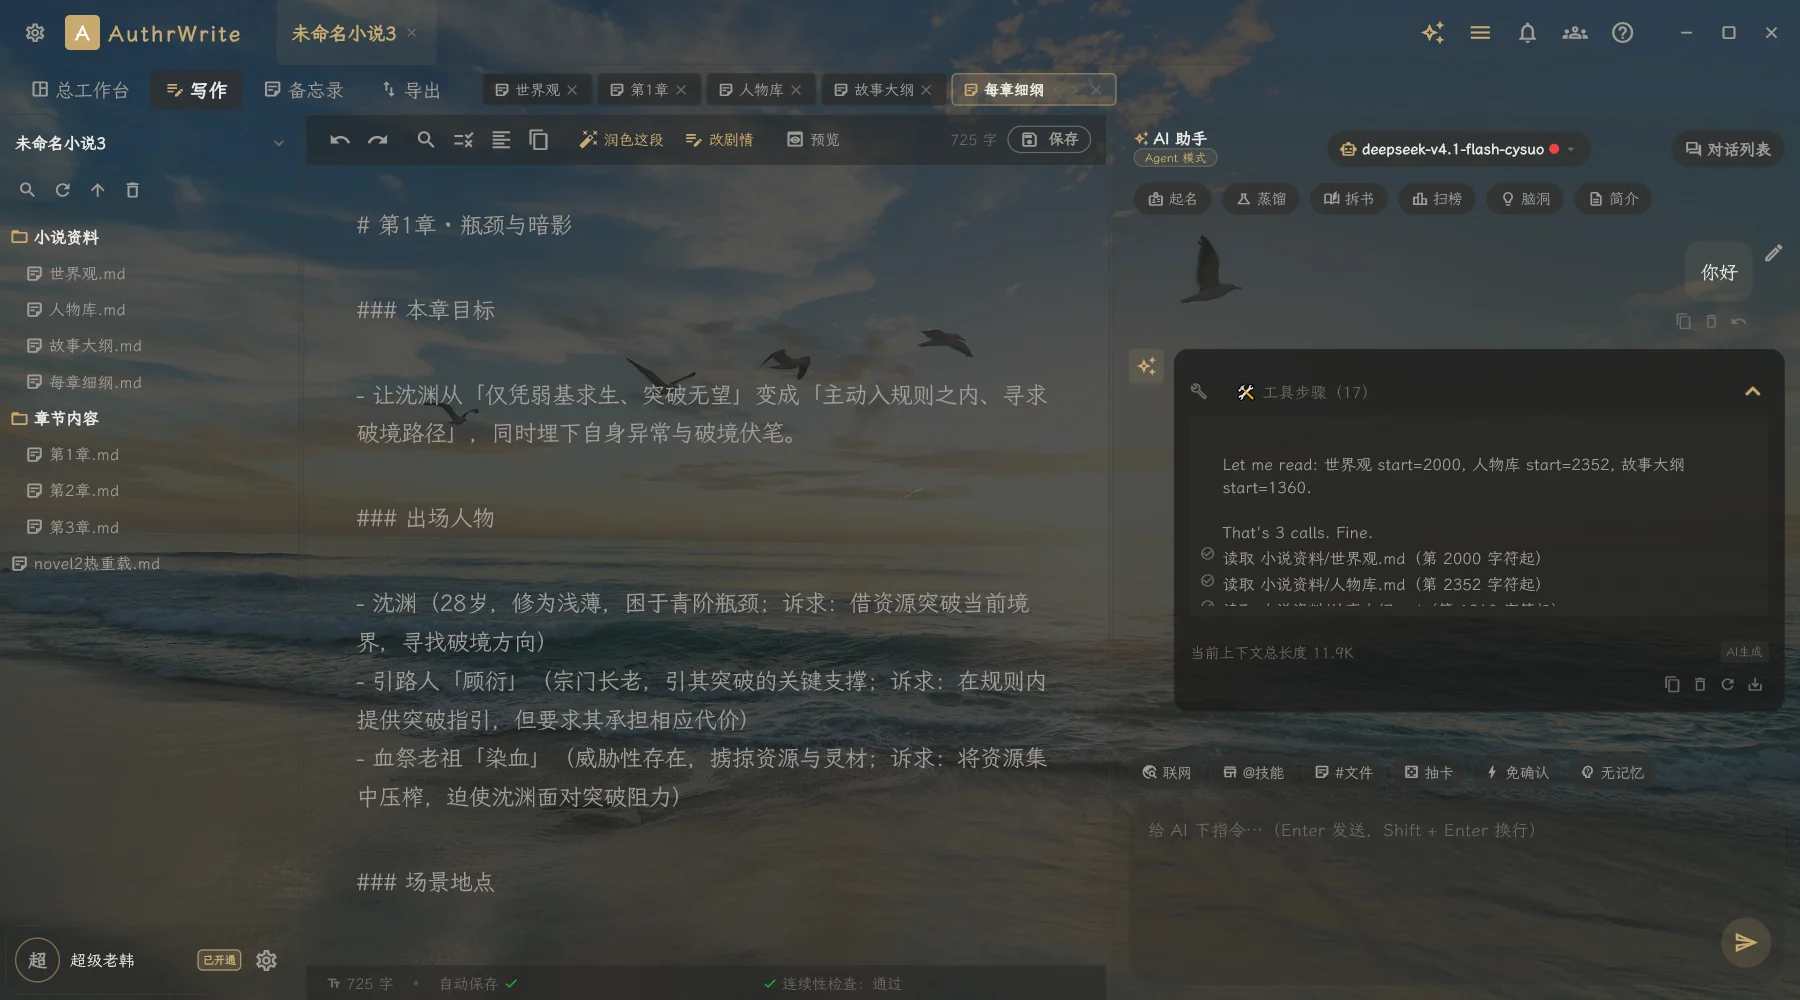
候选稿 → 段级差异 → 逐段接受 → 快照回滚
这是整个产品的骨架。AI 的每一次写文件,都不是 write(file, 全文),而是提一份候选: 想改哪一段、改成什么。客户端拿到候选后做三件事:
- 按段落对齐,左右对照。左「改前」右「改后」,删除标红、新增标绿,不给你一坨新文本让你自己找不同。
- 一次只弹一处,逐段决定。接受 / 拒绝 / 跳过,决定了才轮到下一处。避免"全部接受"变成一次赌博。
- 落盘前留快照,可回滚到最近 50 个版本。就算连着点错了十几次,也能退回到某个具体时刻的稿子。
配套的两个细节,是「敢用」的关键:修改免确认 开关 默认关闭(想快的人自己开),以及每次改动都进审计——谁在什么时候、让哪个模型、改了哪个文件的哪几段。
改前 · 原文
沈渊站在资源分配的石阶下面,等着轮到自己。
他心里很清楚,今年多半又轮不到他。
改后 · 候选
沈渊站在资源分配的石阶下第三级,指节抵着袖口。
轮不轮得到他,看的是谁在台上念名字。
⚠️ 这一屏没有实拍截图:差异弹窗只在真实触发一次 AI 改稿时出现, 而截图当时默认上游渠道返回了无法处理的内容(就是下面 2.3 那张失败态截图)。 我没有用示意图冒充实拍——上面的框只用来讲结构,并已标注「结构示意 · 非截图」。
开书向导:一张表单,把模糊想法收敛成设定集
长篇最难的是开头三章。作者脑子里通常只有一句"我想写个宗门里被压着的弟子", 这时候让他面对一个空白编辑器,等于让他同时做四件事:定世界观、定人物、定节奏、定文风。
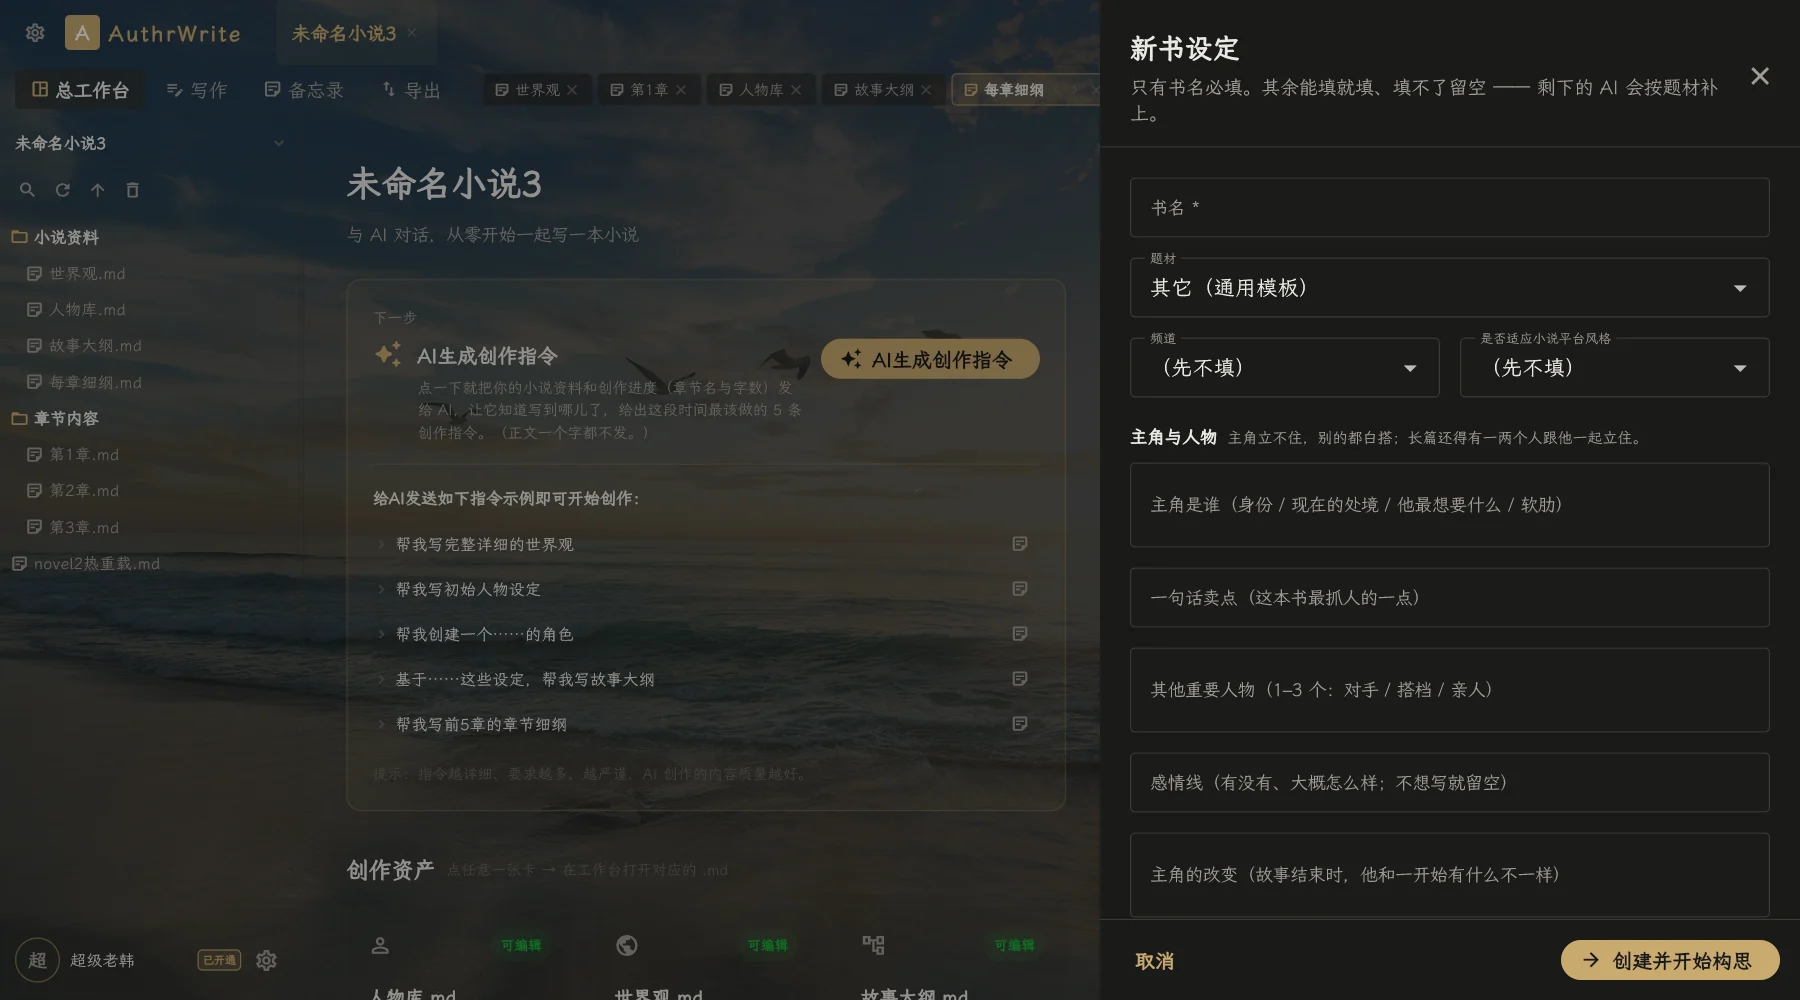
向导把这件事拆成一张表单:书名必填,其余全部可空。题材、频道、是否适配平台风格、 主角是谁(身份 / 处境 / 最想要什么 / 软肋)、一句话卖点、其他重要人物、感情线、主角的改变。 能填的就填,填不了的留空,剩下的由 AI 按题材补——先让人迈过去,再让人改得动。
提交之后不是丢给模型随便发挥:这些原始字段会被要求原样落进 小说资料/世界观.md,同时生成一份开书用的「开局提示词」。 于是设定从"只在开局出现过一次的话"变成文件里的长期依据,后面每一章 AI 都能读到同一份事实。
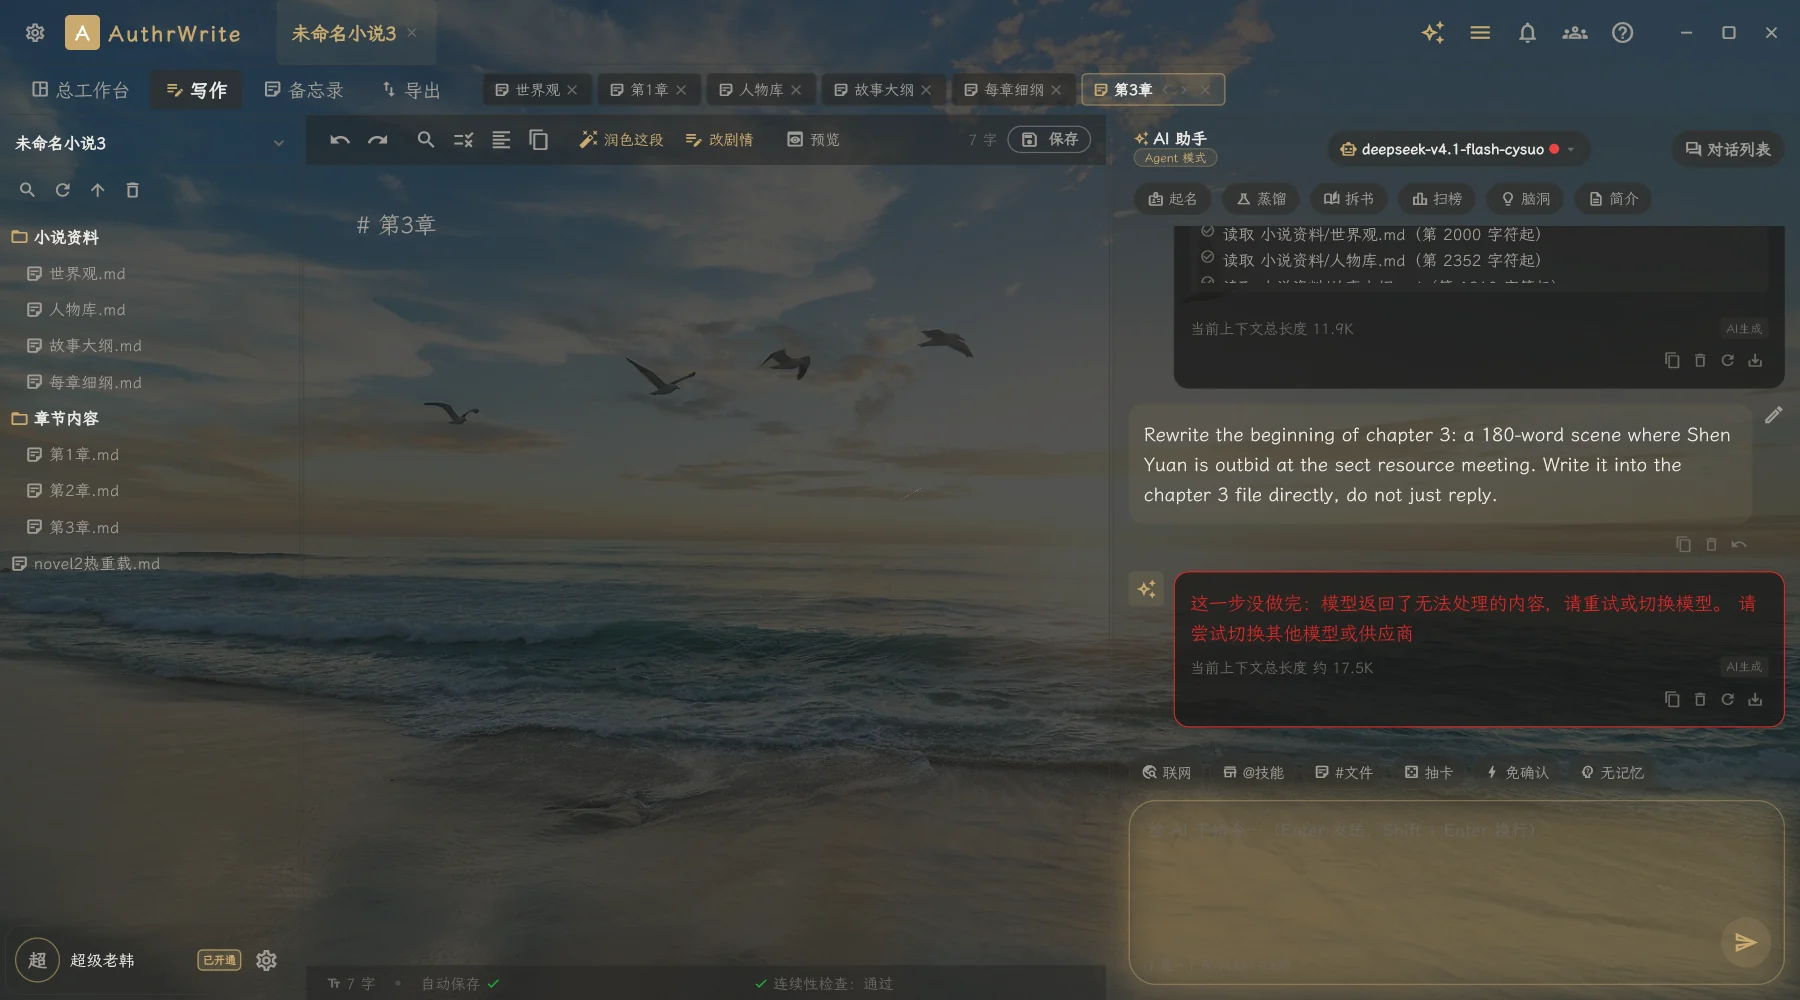
状态设计:错误只给下一步
长耗时 + 多上游 + 计费,这三件事叠在一起,失败是常态而不是例外。所以客户端做了一个统一状态层, 所有网络与 AI 调用都走它:加载中、空态、失败可重试、额度耗尽、网络中断,五类各有各的呈现, 而不是每个页面自己写一套 SnackBar。
一条硬规则:错误提示里不出现接口地址、不出现异常原文、不出现 HTTP 状态码。 用户看到的必须是"我现在该做什么"。
- 失败:「这一步没做完:模型返回了无法处理的内容,请重试或切换模型」+ 两个按钮(重试 / 换模型)。
- 额度不足:AI 输出页不报数字(报数字只会变成干扰),模型选择页才报「至少需要多少积分」并说明为什么,且「购买套餐」只出现一次。
- 操作不成条件:没选中正文就点「润色这段」,弹的是「先在正文里选中要改的那一段,再点这个按钮」,而不是静默无反应。
- 长耗时:工具步骤栏流式追加、自动跟随最新一行,并带上秒表——卡住时能看出卡在哪个工具、卡了多久。
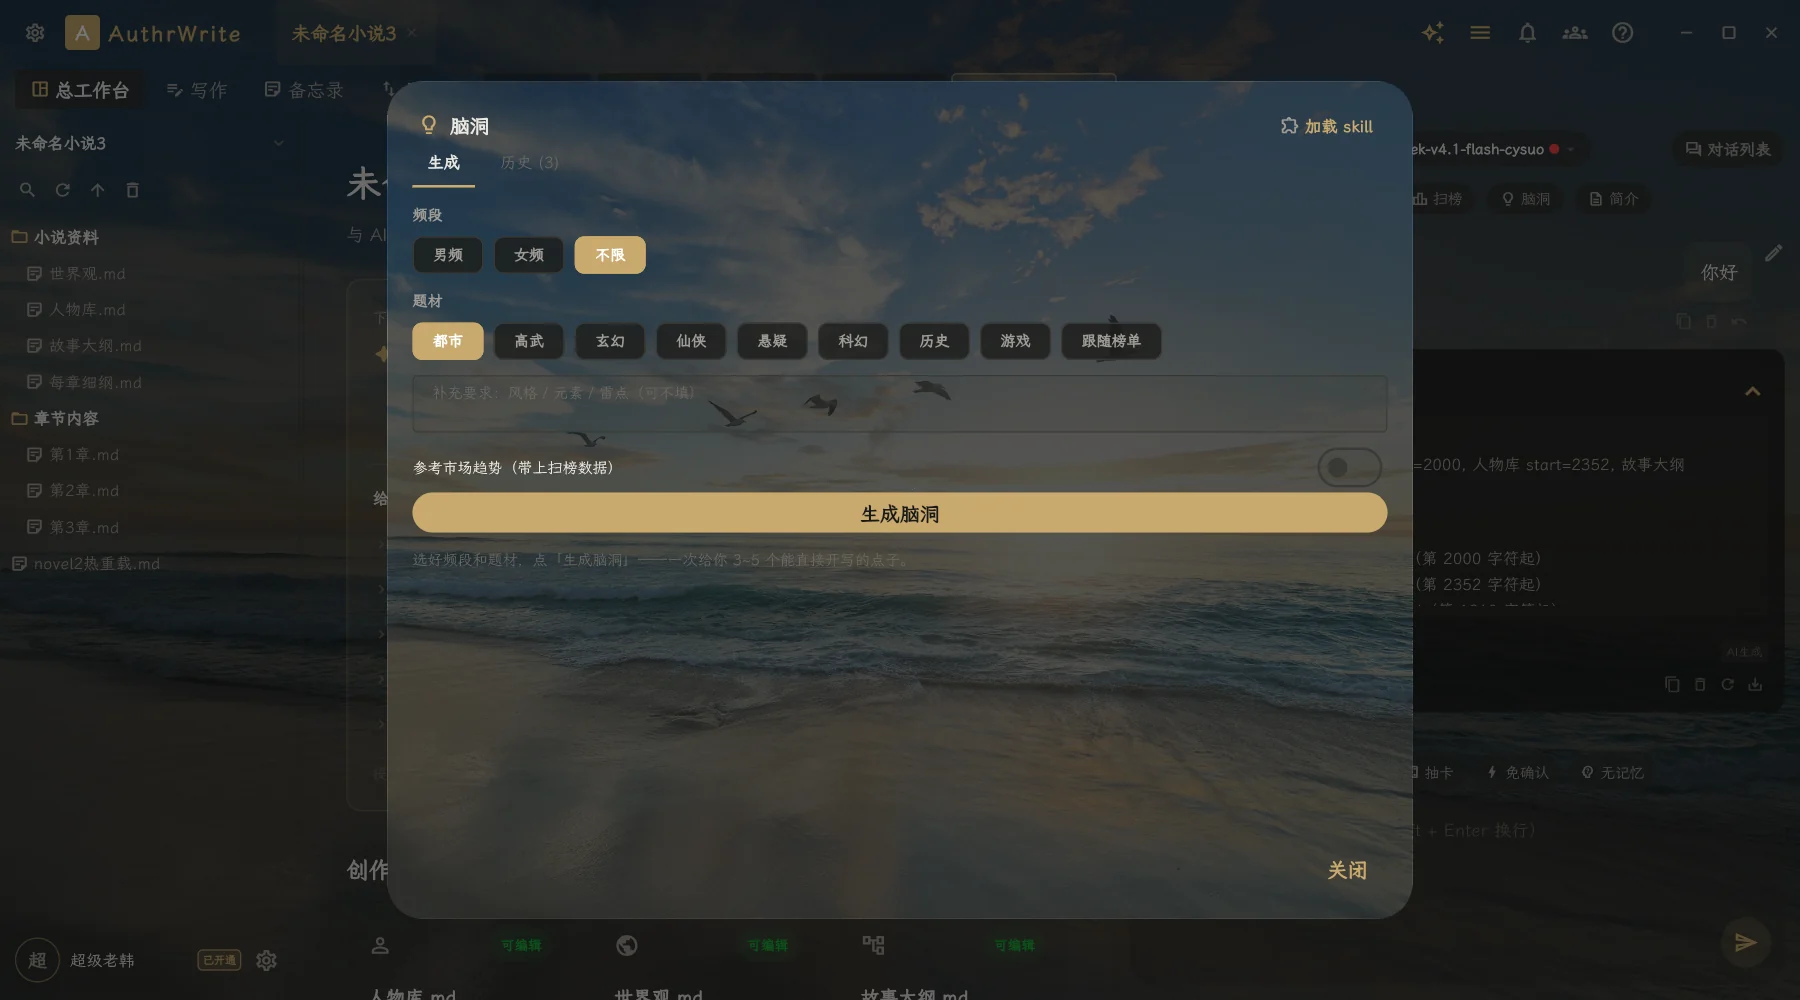
六个快捷工具,和一套能筛的模型货架
作者的高频动作不止"写"。工具栏上常驻六个工具:起名(书名 / 人名候选并打分)、 扫榜(把榜单数据拉回来做参考)、拆书(拆结构,不是拆文笔)、 蒸馏(把一段范文的写法提成可复用的规则)、脑洞(按频道 + 题材给 3–5 个能直接开写的点)、 简介(一句话卖点到简介的展开)。每个工具都是一个独立面板,带自己的历史记录与「加载 skill」入口。
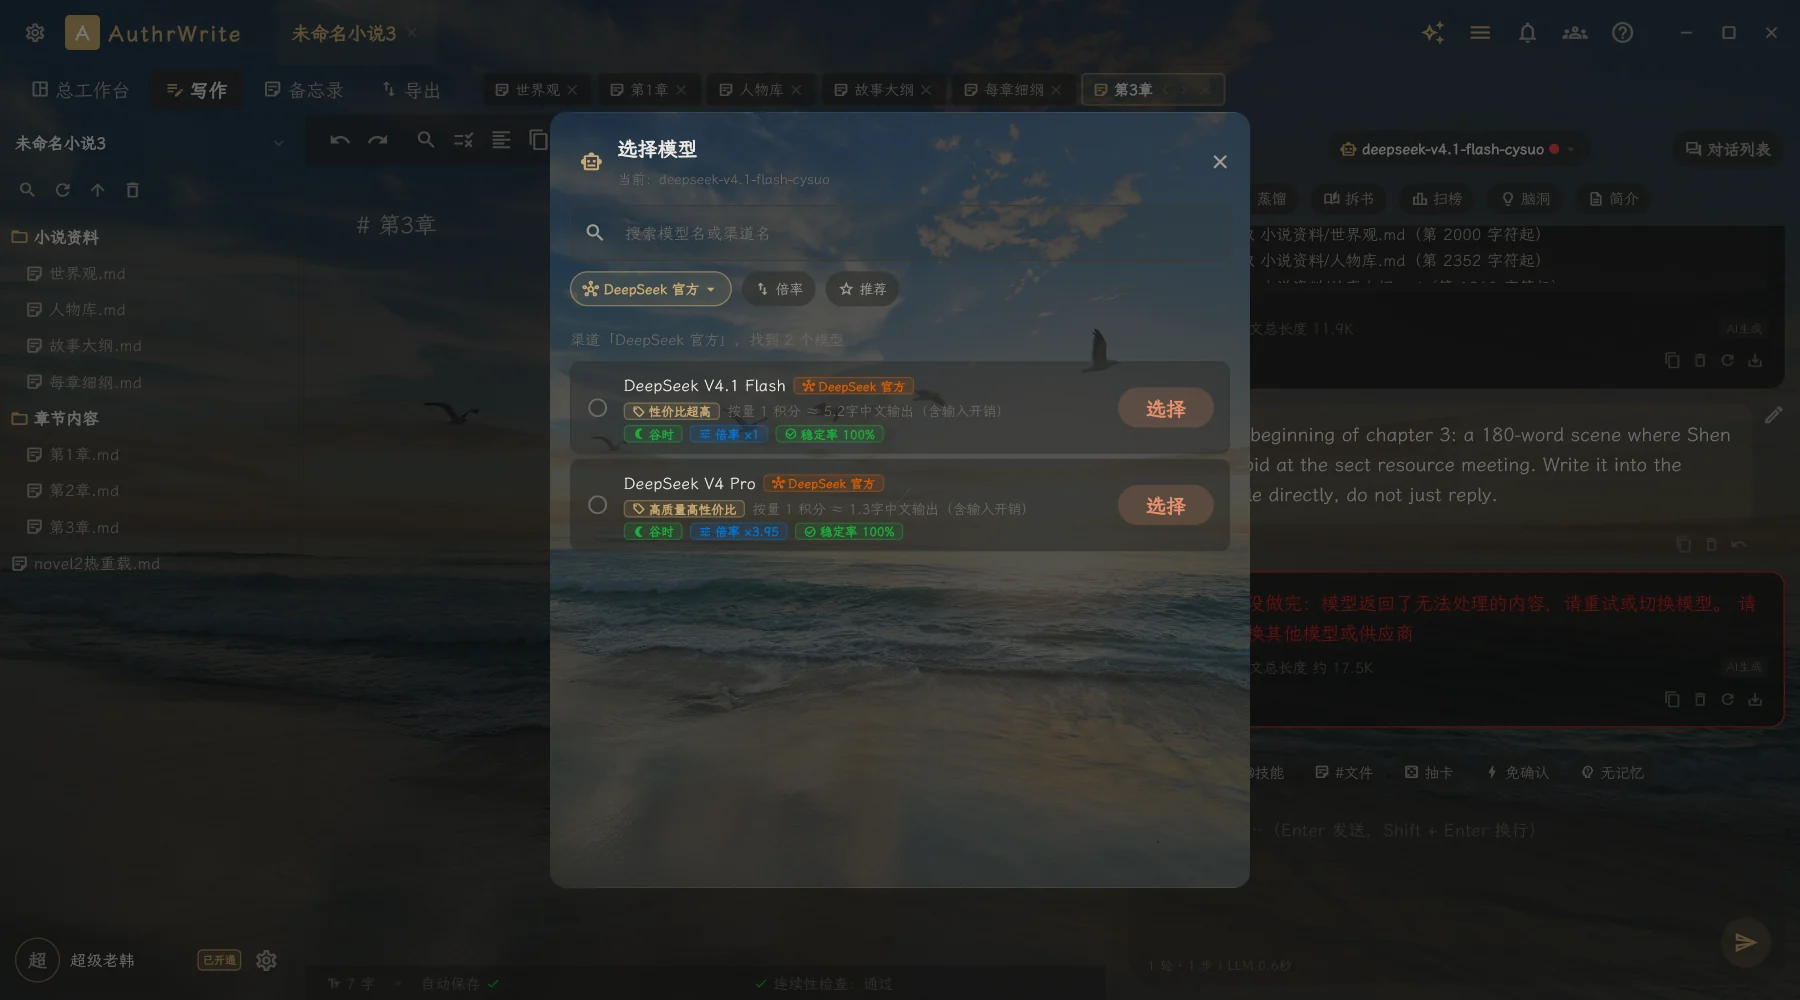
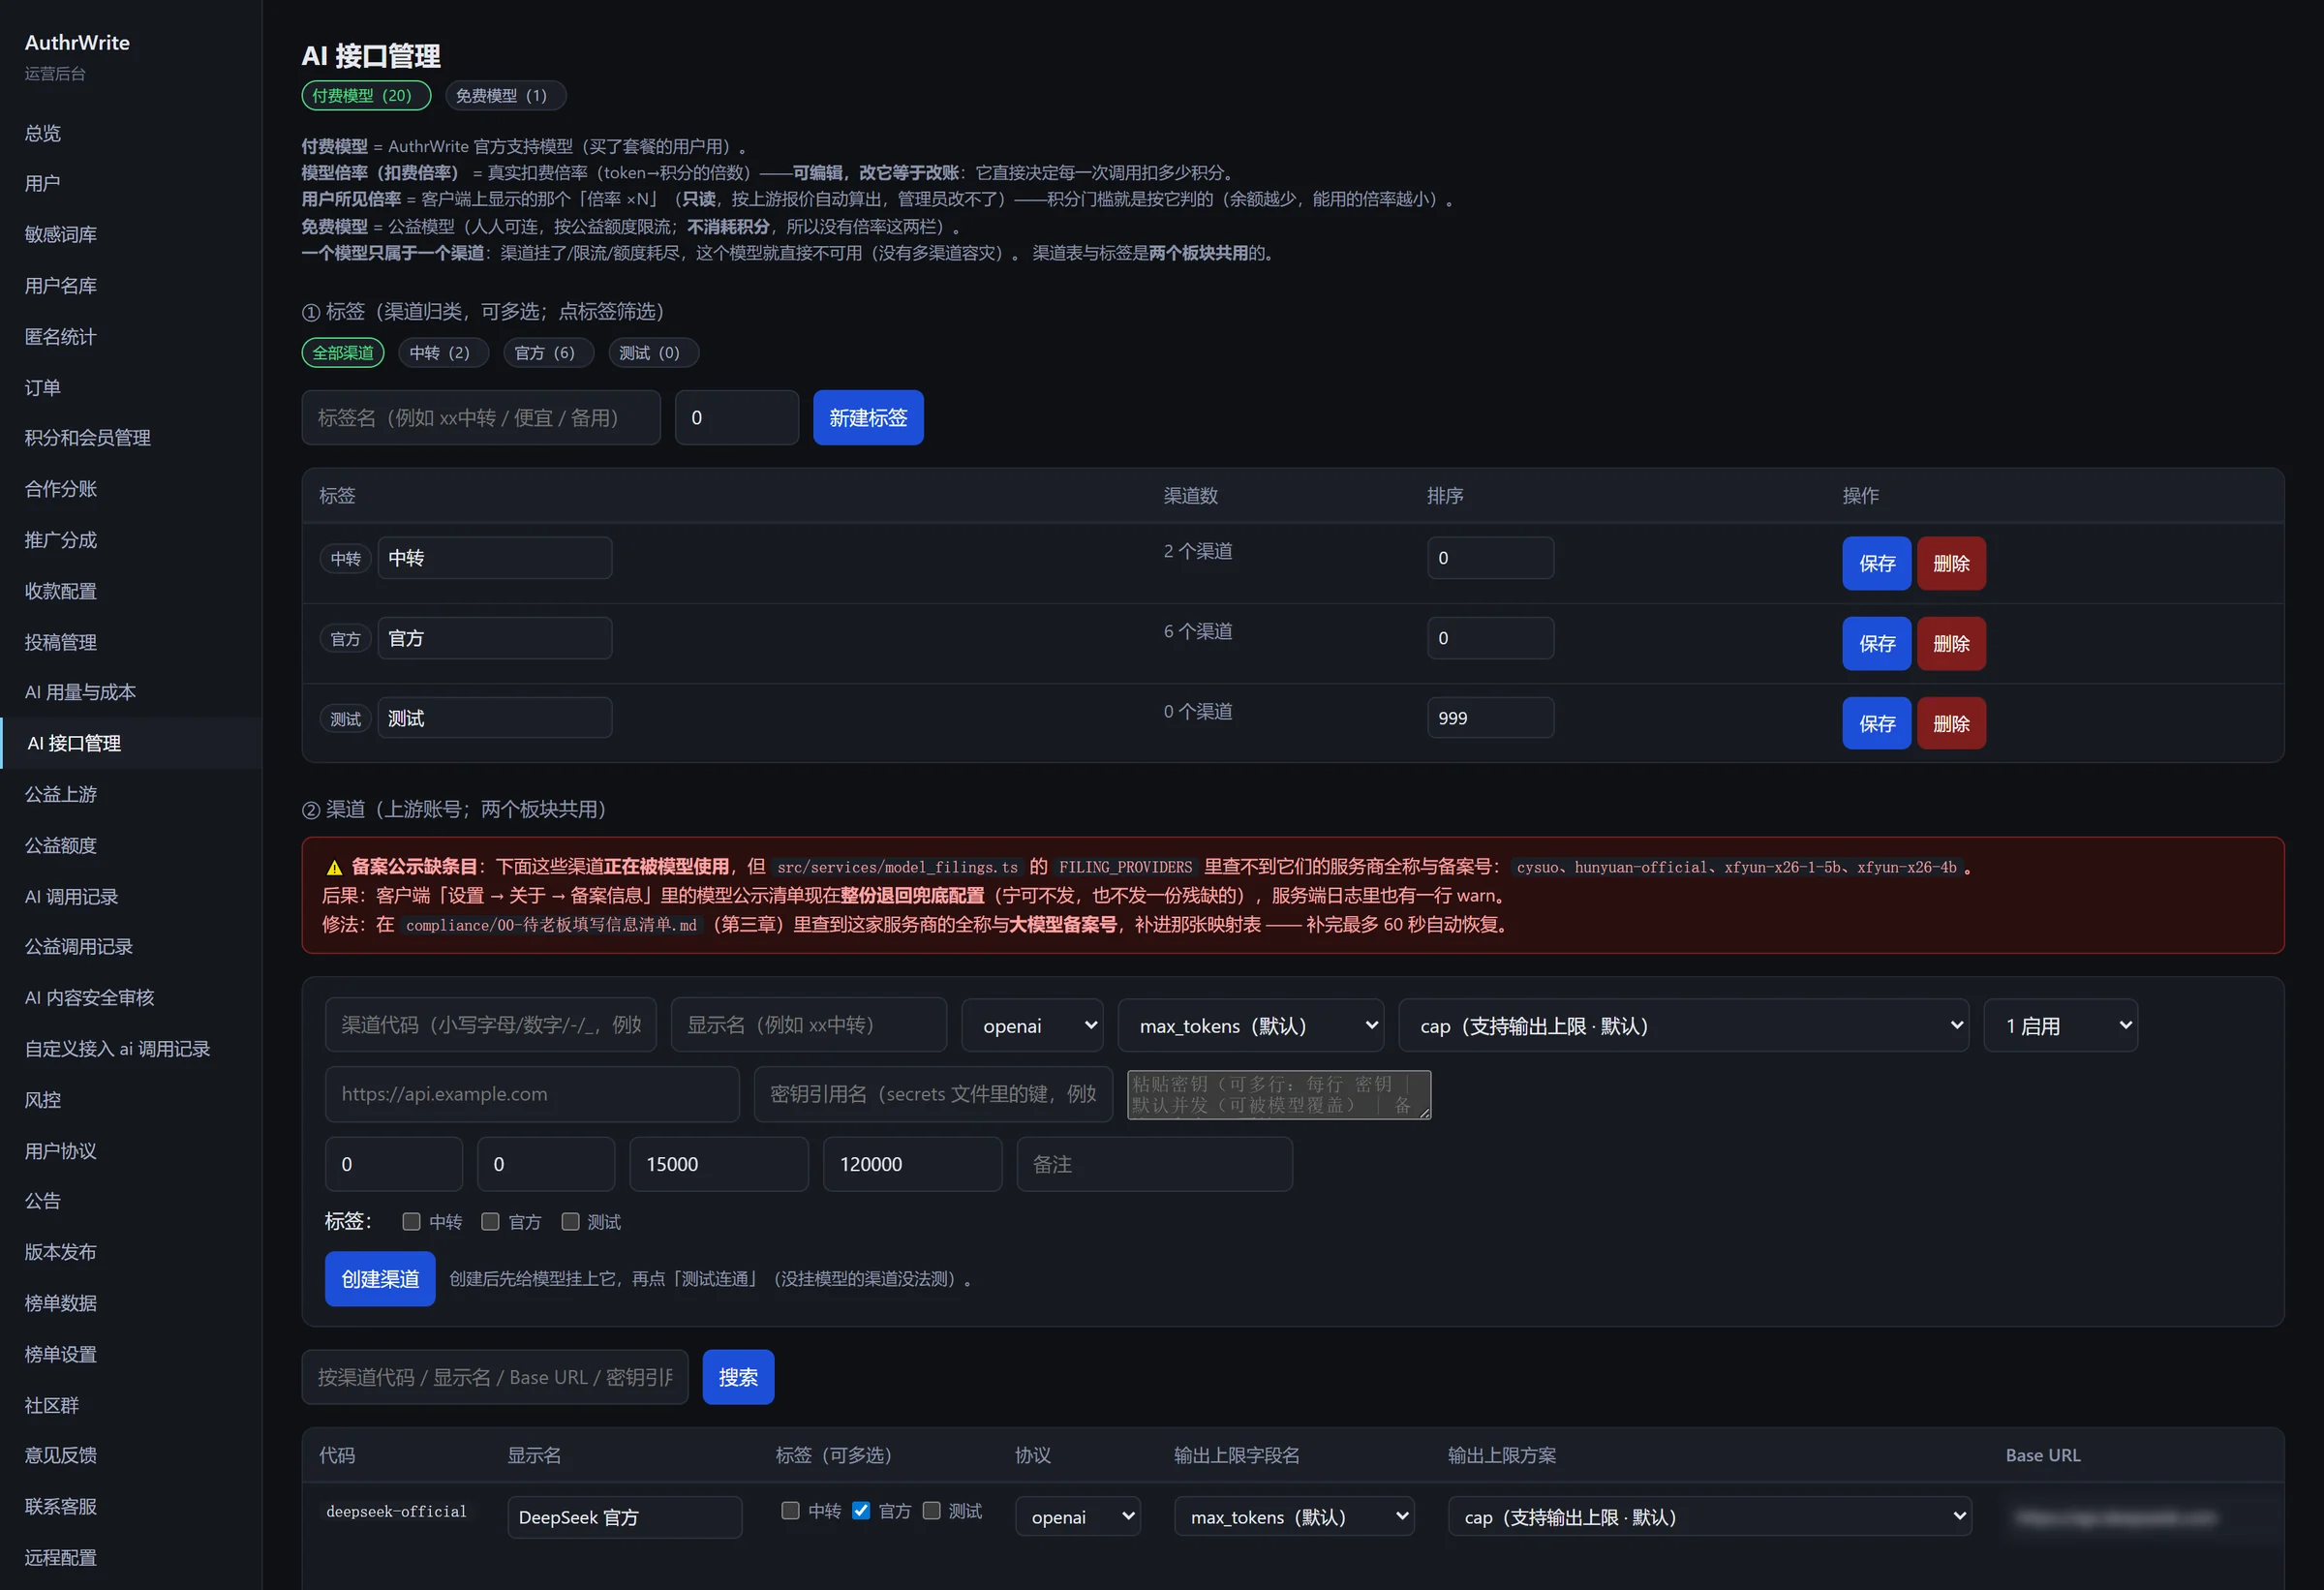
模型那一侧解决的是另一个问题:上游会挂、会慢、会涨价。所以客户端把 21 个模型(20 个付费 + 1 个公益)挂在 8 条上游渠道上,可以按渠道筛、按倍率排, 每个模型直接标出「谷时 / 倍率 ×N / 稳定率 / 1 积分大约等于多少字」。 后台配了连通测试、响应时间与自动禁用——渠道坏了,用户看到的是"这个模型现在不可用",而不是一次莫名的超时。
钱要算得清,错要查得到。
一个人也得有一套运营系统。
客户端决定用户敢不敢用,后端决定这门生意能不能长期算得明白。 这一节讲四件事:数据怎么长、测试怎么兜、钱怎么走、后台怎么用。
技术栈:一套人能维护的东西
- 客户端 Flutter(Windows + Android 一套代码),自绘外壳 + 自建编辑器;Windows 用系统托盘、单实例、窗口拖拽这些原生细节自己补。
- 服务端 Node.js + Fastify(TypeScript),SSE 流式转发,请求体上限按 AI 长上下文放宽到 8MB。
- 存储 PostgreSQL 16(主库)+ Redis(限流 / 幂等键 / 缓存),没有引入消息队列——单人维护的系统里,多一个中间件就多一个半夜会响的东西。
- 接入层 Caddy 2.6(原生 apt 版,systemd,caddy 用户运行,自动签证书),按域名拆站点:官网 / API / 后台各自一套响应头与限流规则。
- 部署 腾讯云上海单机。没有 K8s、没有容器编排,因为现阶段瓶颈是获客,不是并发。
101 个数据库迁移:只增不改
从 0001_init.sql 到 0102_usage_estimate_metrics.sql, 一共 101 个迁移文件,都跑在同一个生产库上。三条规矩:
- 只增不改:已发布的迁移文件永不编辑,改结构只能追加新文件。线上跑过的东西就是历史,不能重写。
- 幂等:每个迁移带版本表登记,重复执行不报错、不重复建表;部署脚本可以放心重跑。
- 可回滚:破坏性变更(删列 / 改类型)先加新列、双写、再切读,最后才删旧列——中间任何一步都能退。
为什么在意这个:一个人维护、一台机器、一个库,没有 DBA 兜底。 迁移写坏一次,丢掉的是真实用户的稿子。
测试:客户端 4,500+ 用例 / 后端 2,100+ 用例
客户端 452 个测试文件、后端 378 个测试文件,合计 4,500+ / 2,100+ 个用例, 长期保持 0 失败。重点不在数量,在覆盖的是哪一类东西:
- 契约测试:客户端与服务端的字段、枚举、版本比较、错误码必须逐条对上——这类 bug 上线才发现最贵。
- 钱的测试:预扣 / 结算 / 多退少补 / 余额闸门 / 退款不动积分,都有固定用例,改计费逻辑先跑它们。
- 交互回归:树结构变化导致子树重建、切页面丢对话、单实例、窗口拖拽这类"真机才报"的问题,都补成了可重跑的用例。
- UI 安全网:外壳做了注入接缝与烟雾测试,改一个页面不会静默把整个工作区打成白屏。
钱:会员 + 积分双轨,回调、对账、分成
双轨计费。会员卖时间(到期日),积分卖用量(按 token 折成积分)。 一次调用走完整条链:预扣冻结 → 上游返回 → 结算多退少补,在途请求计入占用, 余额 ≤ 0 立刻停,不会出现"先赊着"的窟窿。
支付。支付宝 App 支付 + 手机网站支付双通道。异步回调做验签 + 幂等(同一笔回调重复投递不会重复发货), 客户端「我已完成支付」只是把订单标成待确认,钱和权益的入口只有一处。
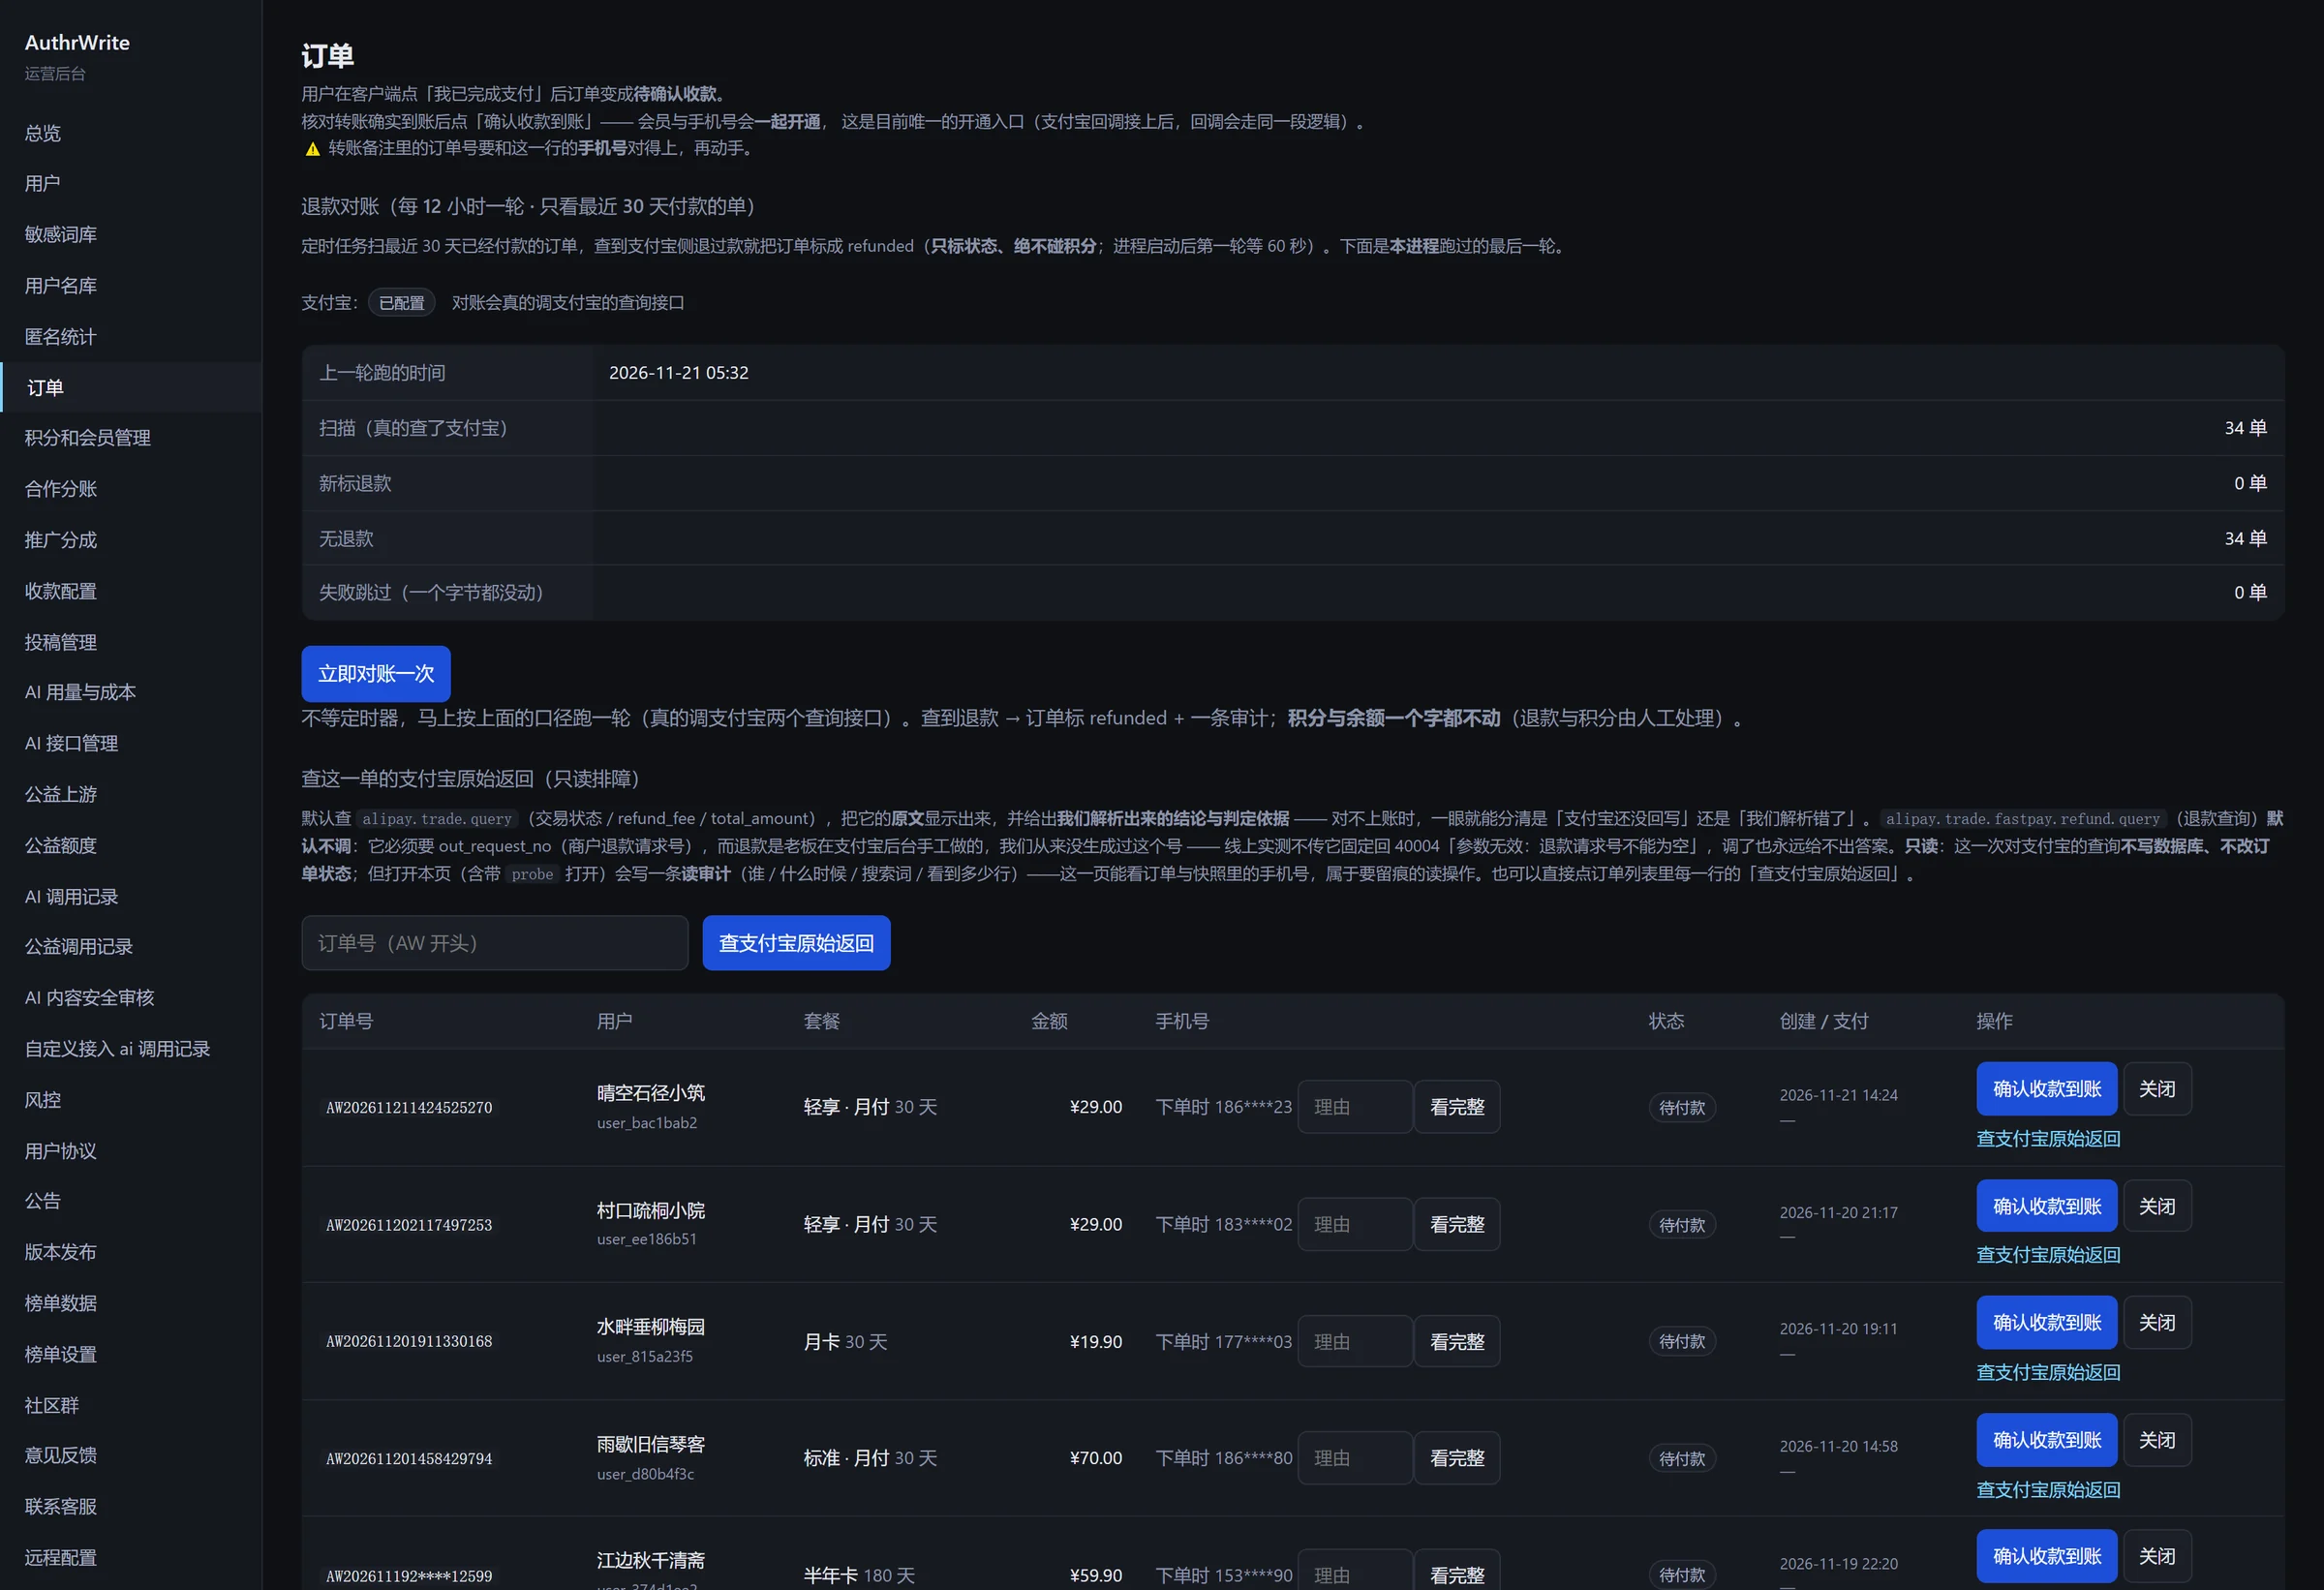
对账。每 12 小时扫一遍最近 30 天已付款订单,真的去调支付宝查询接口;查到退款只把订单标成 refunded,一个字节都不动积分与余额——退款与积分是两件事,混在一起就没法对账了。 页面上同时给出"这一轮扫了多少单 / 新标退款多少 / 失败跳过多少"。
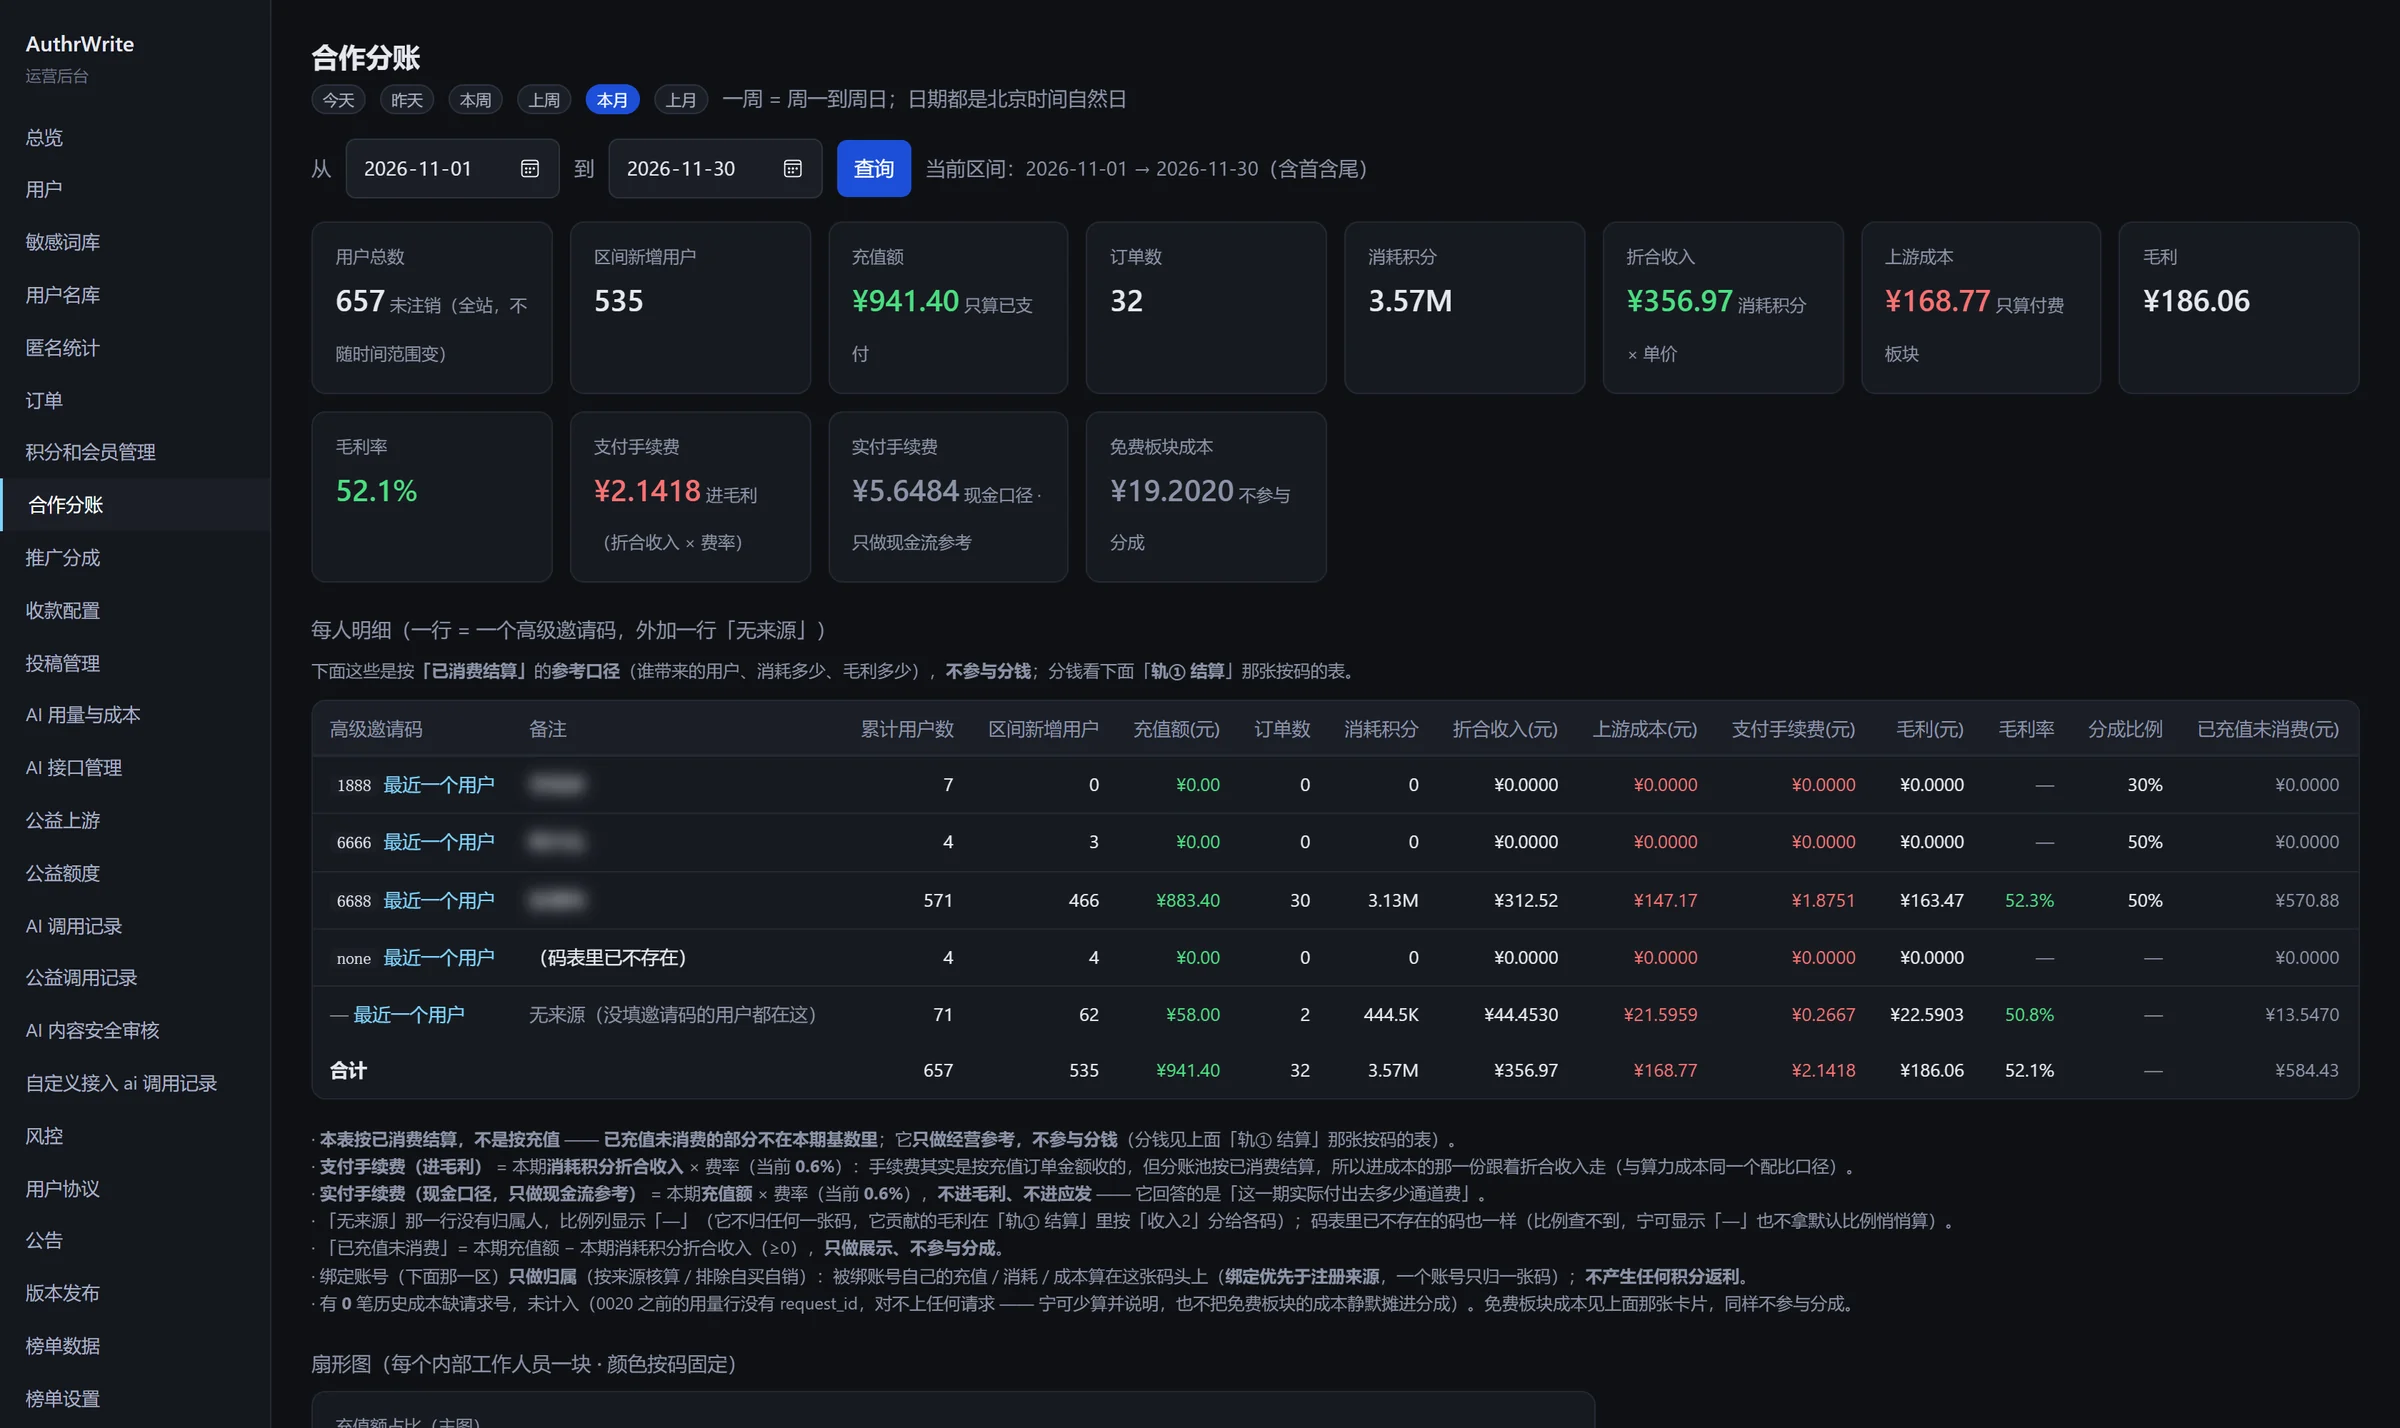
分成。合作方按高级邀请码归因,按月结算:区间充值额、消耗积分、折合收入、上游成本、 支付手续费、毛利率、分成比例、已充值未消费,逐列列出,并区分「进毛利的手续费」与「现金口径的实付手续费」。 结算表按月幂等,重跑不会重复计。
后台:把运营动作做成页面,而不是 SQL
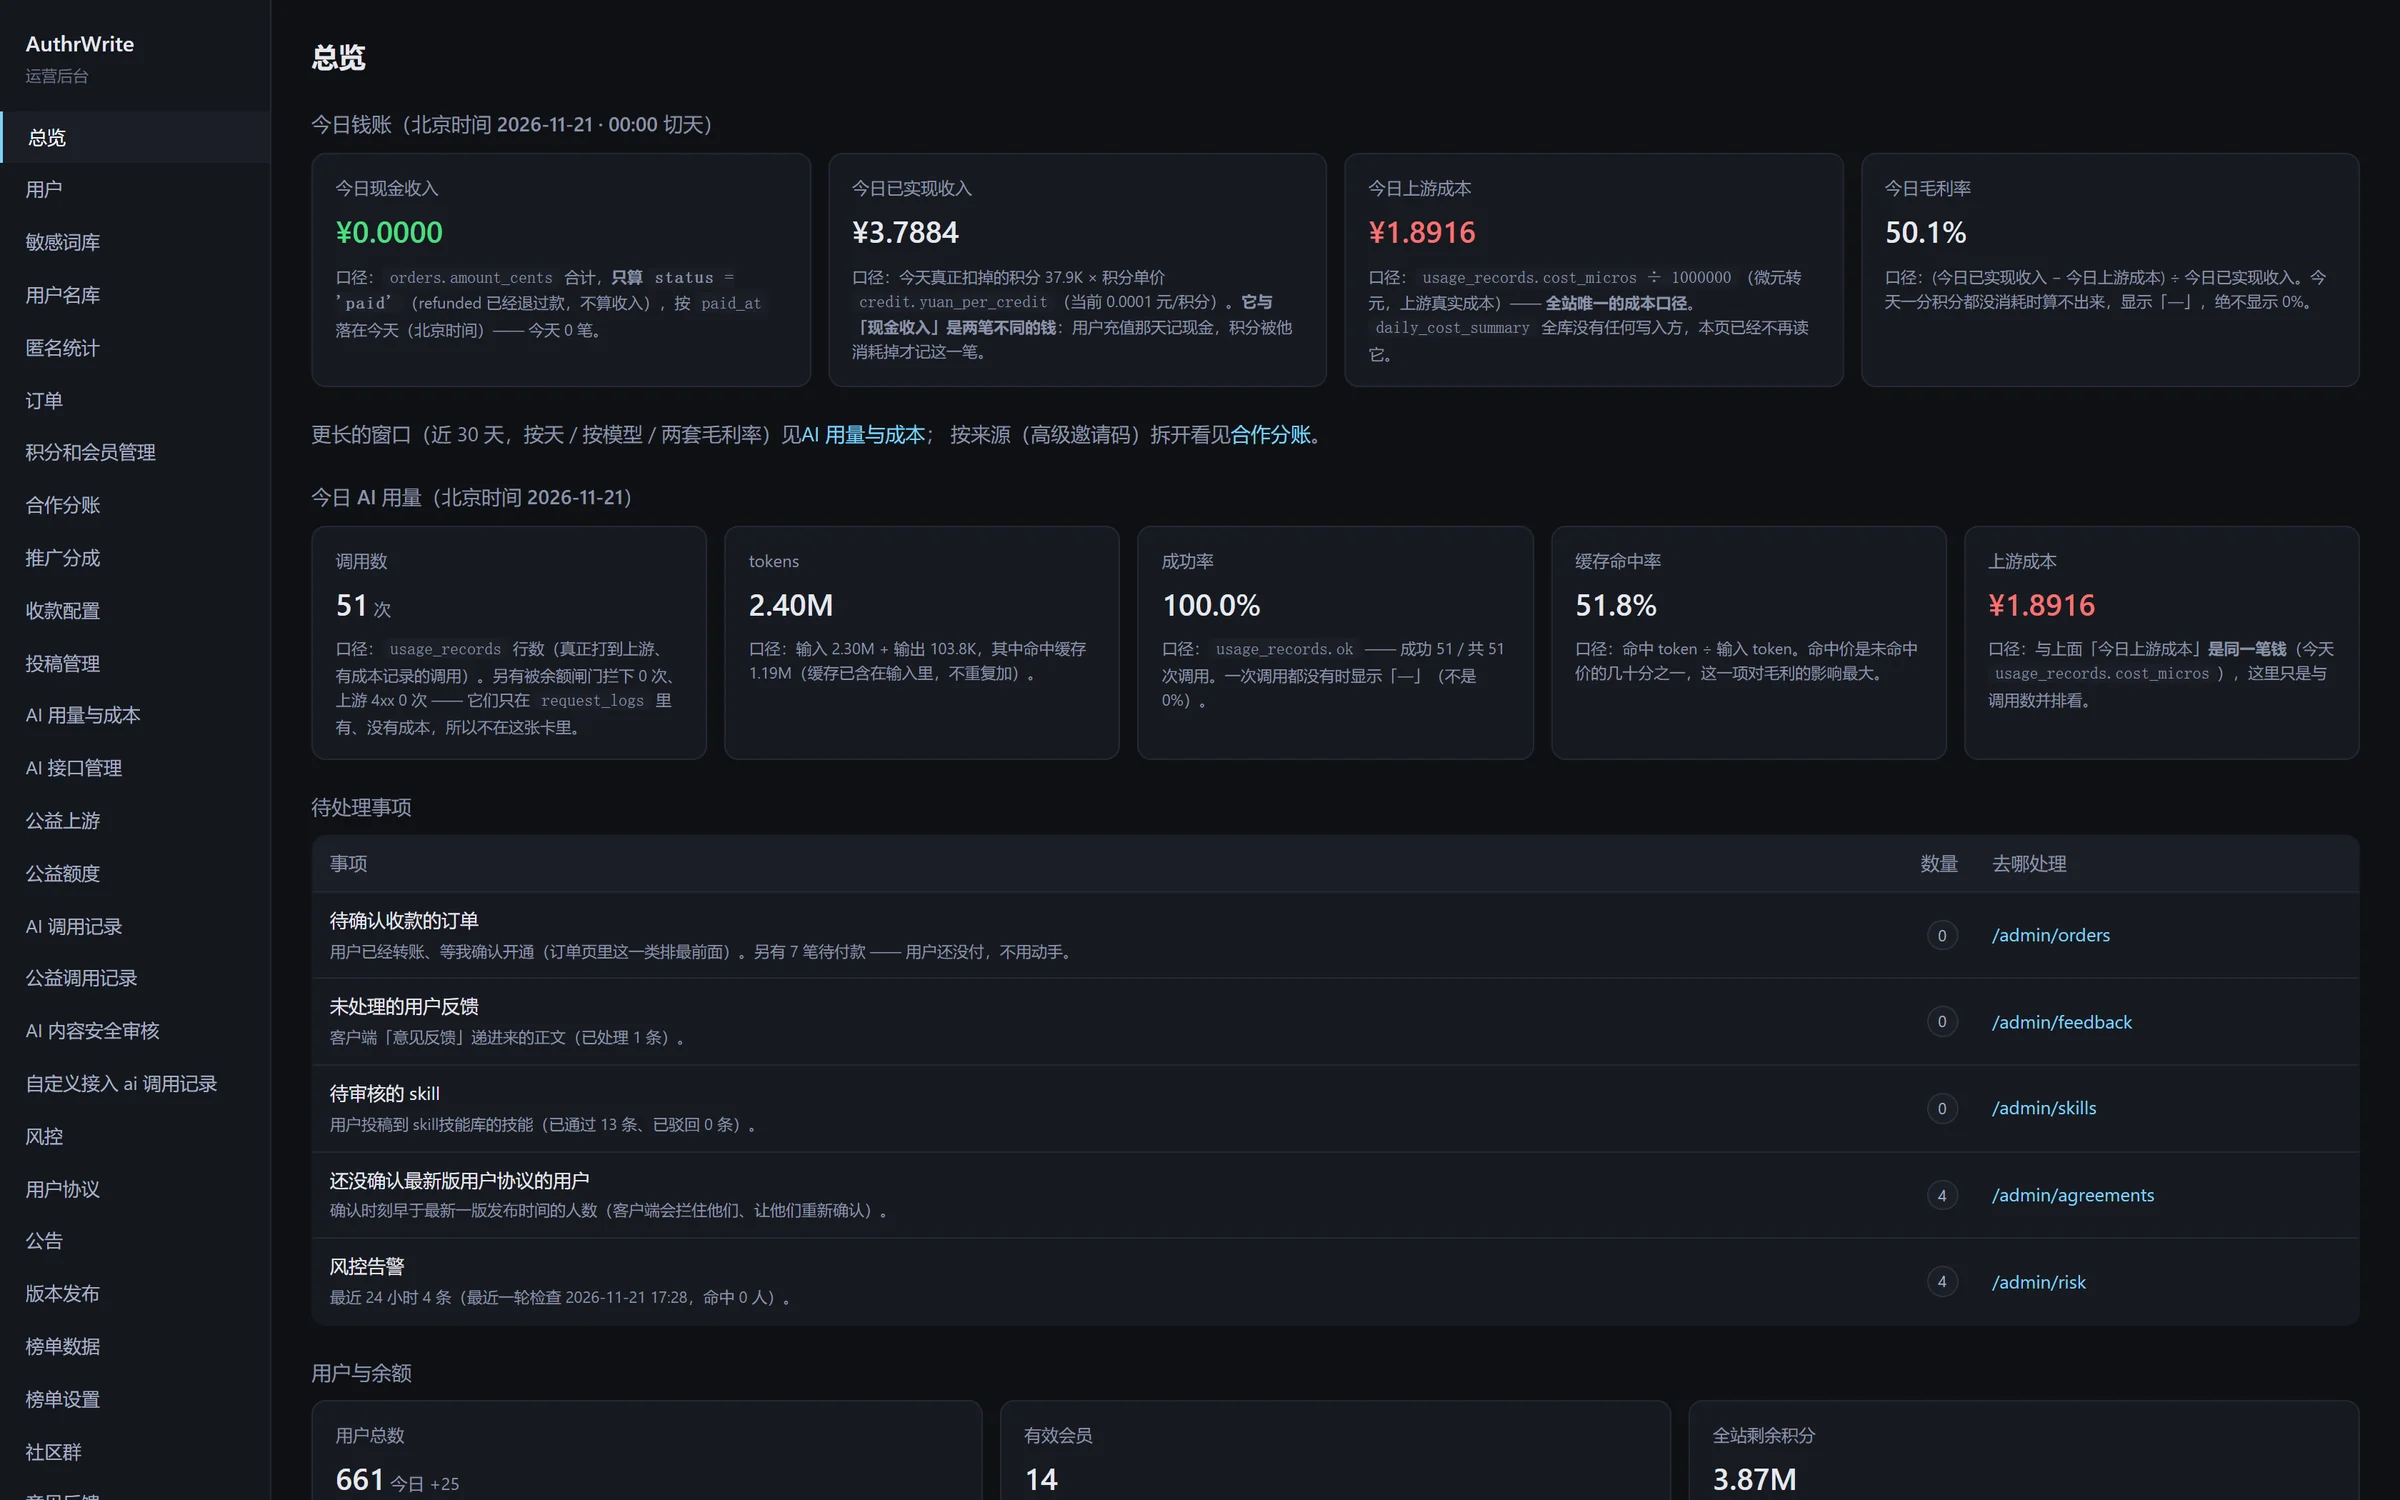
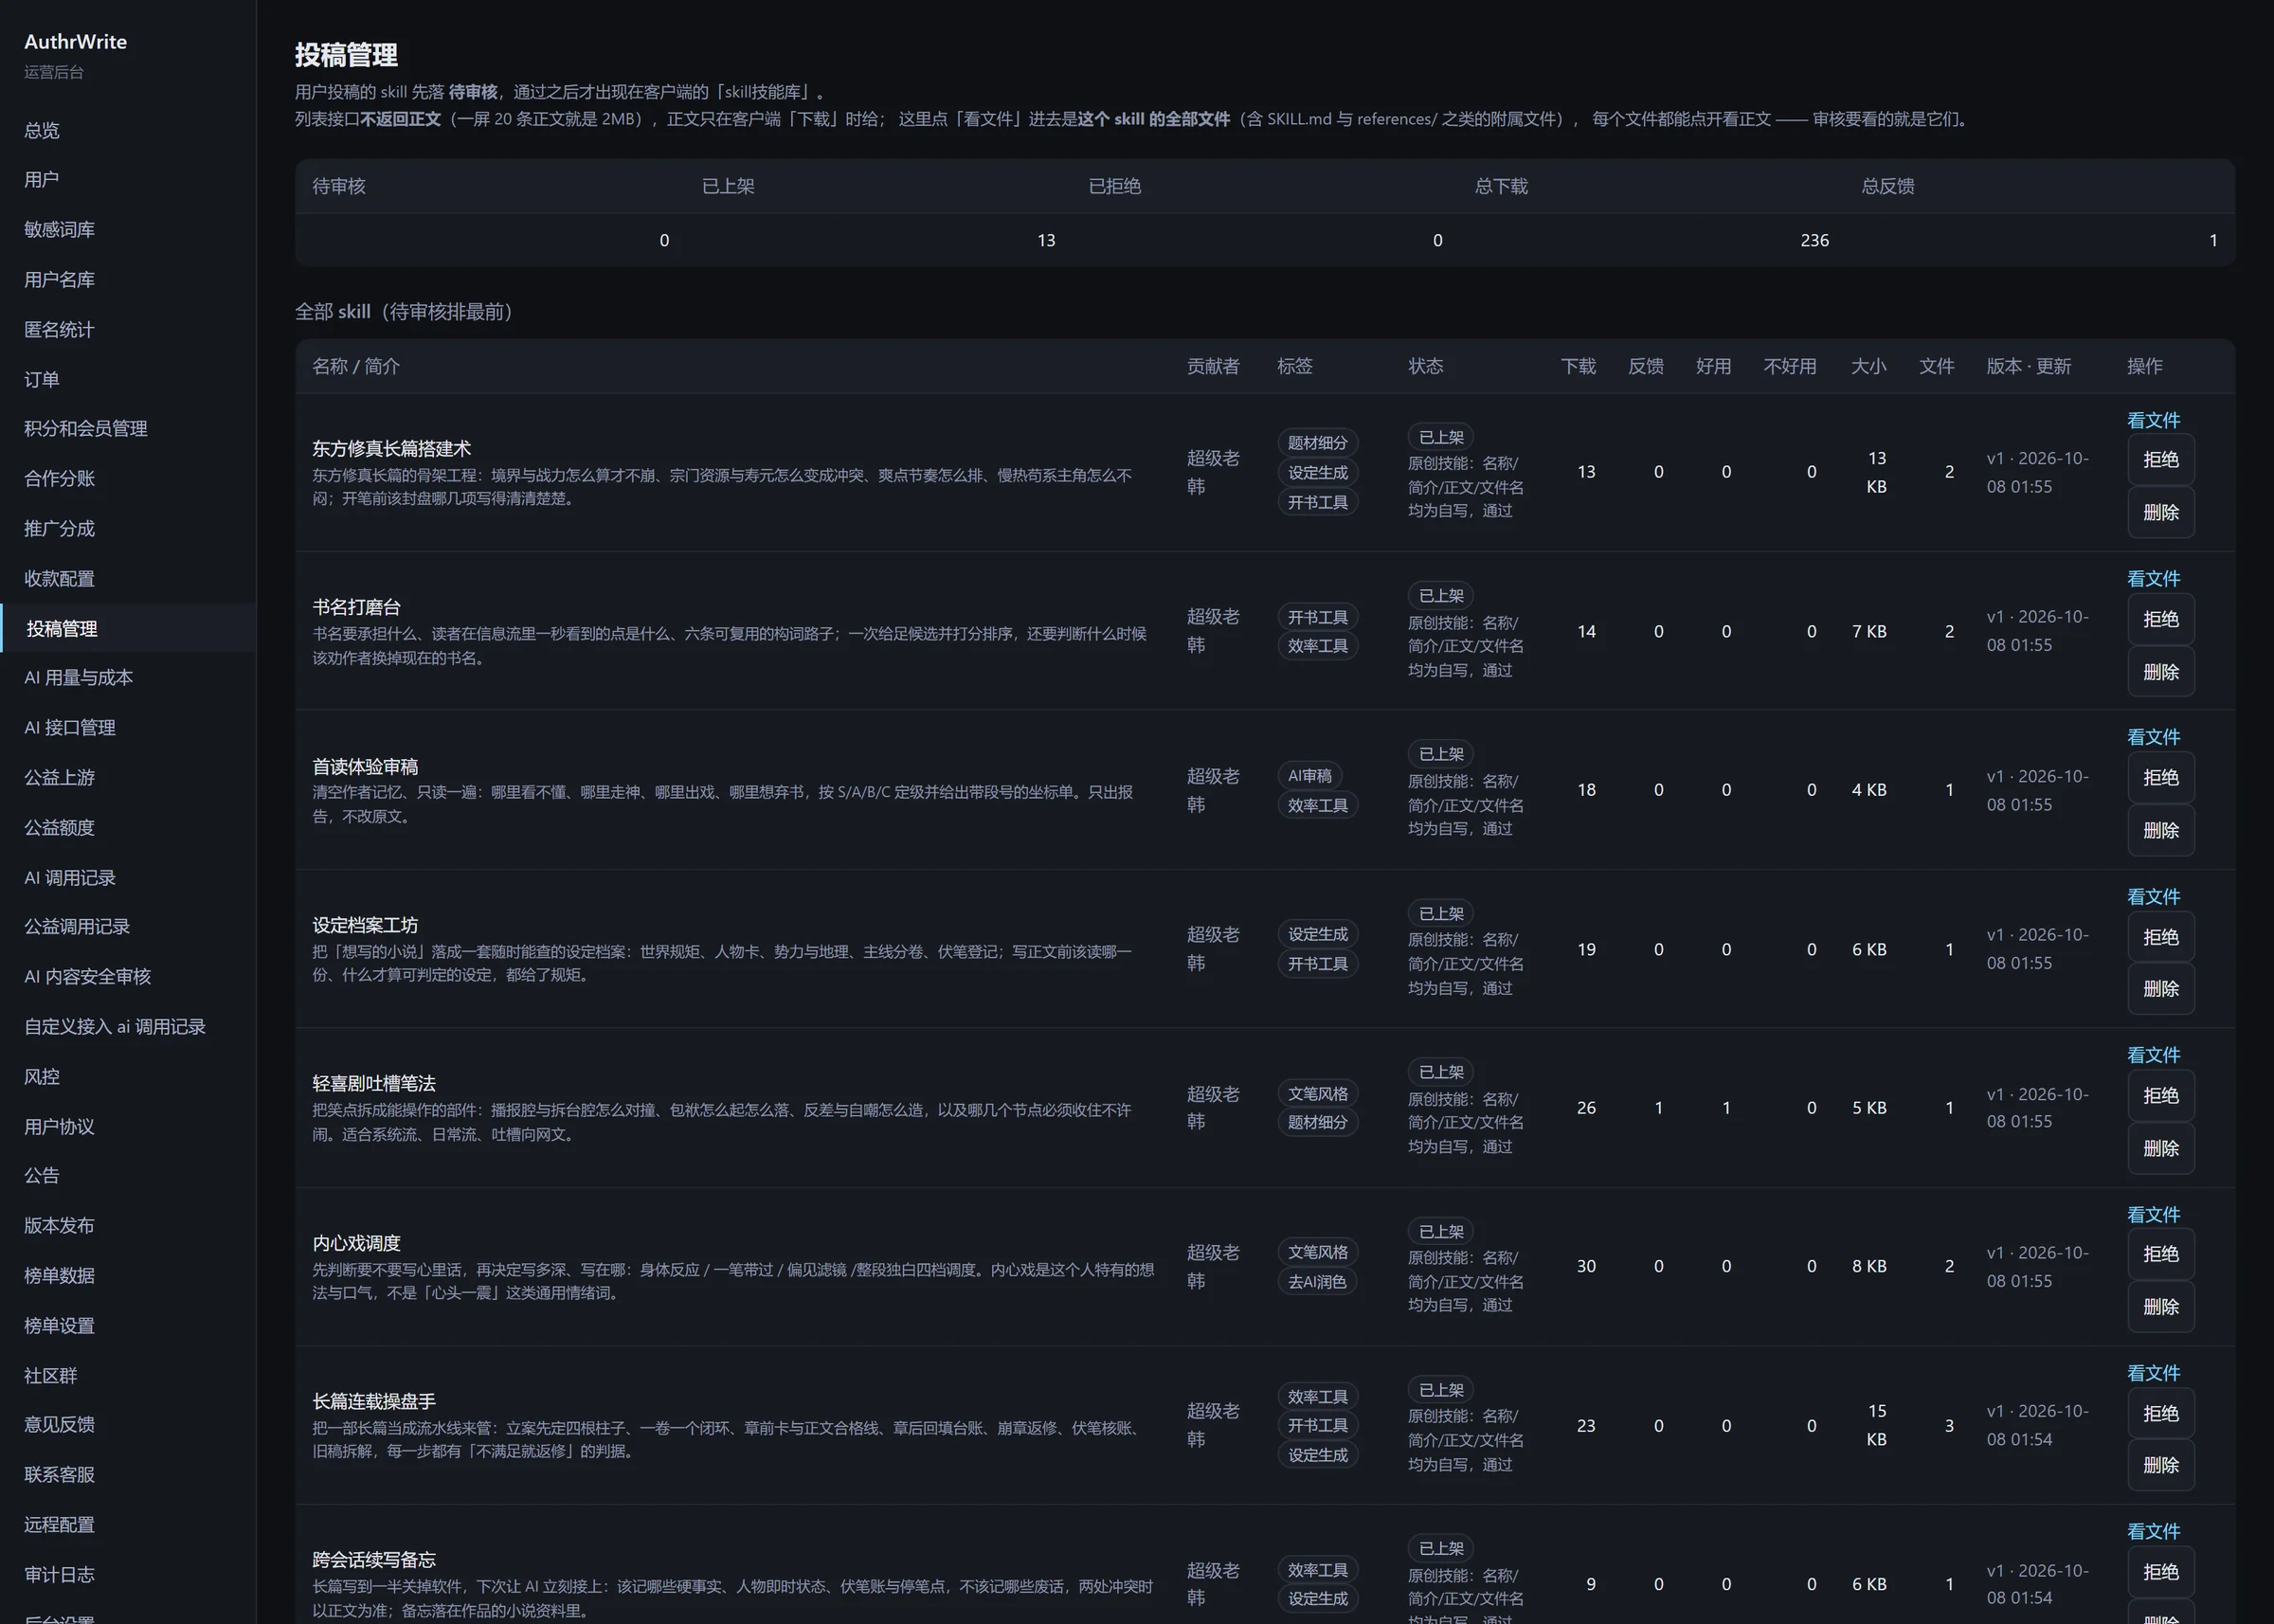
后台是服务端直接渲染的(无前端框架),一共 31 个页面,核心是这些:用户、订单、积分与会员、 合作分账、推广分成、投稿审核、AI 用量与成本、AI 接口管理、公益上游与额度、内容安全、风控、 版本发布、审计日志。原则是:任何一个运营动作,都不需要我登录数据库。
下面每一条,都是主动放弃了什么。
做产品最容易写的部分是"我做了什么",最难写的是"我故意没做什么"。 这一页只列六条,每条都写清楚代价和兜底。
| 放弃了什么 | 换来了什么 | 代价 / 兜底 |
|---|---|---|
| 放弃「AI 直接改正文」的爽感 | 每一处改动都可逐段否决,作者敢让 AI 碰三个月的稿子 | 代价是每处多一次点击;兜底是「修改免确认」开关(默认关闭,想快的人自己开)。 |
| 放弃多渠道容灾(一个模型只挂一条上游) | 计费口径唯一、成本可核算,每一分钱都能追到哪次请求 | 代价是渠道挂了这个模型就不可用;兜底是连通测试、响应时间、自动禁用,加上用户可随时换模型。 |
| 放弃「一个毛利率糊过去」 | 并排给两套口径:不计免费板块成本 / 计入免费板块成本 | 代价是界面上要看两遍;兜底是每张卡片下面写清口径,两套数字永远同时出现。 |
| 放弃「额度不足就报个数字」 | 错误只说下一步,不暴露接口地址与异常原文 | 代价是排障要靠日志;兜底是模型选择页仍报「至少需要多少积分」,输出页只留一句人话。 |
| 放弃容器编排(不上 K8s、不拆微服务) | 单机 + 原生 Caddy + 一个 Postgres,一个人能整夜改完直接上线 | 代价是单点故障;兜底是迁移可回滚、定期备份、境外另有一台备份环境,出事先恢复再排查。 |
| 放弃「后台随手写 SQL」 | 运营动作全部页面化,且带审计日志(谁 / 何时 / 看了什么) | 代价是多写一套后台;兜底是服务端直接渲染,没有前端构建链,改一页不担心打包。 |
能上线收费,是因为该走的流程都走完了。
这部分不产生任何用户价值,但少了任何一项,产品就只能停在"朋友之间试用"。
内容这一块单独说一句,因为它最容易被当成"填个表": 生成内容的输入输出是 AES-256-GCM 字段级加密入库的,表里只挂账号 ID, 没有手机号、没有 IP、没有设备指纹列,默认 210 天到期硬删除并留删除凭证。 「留存 ≥6 个月」不是任何法规的明文要求,是主动留出的合规冗余——所以反向约束也必须自己守住。
一个还没爆的产品,但每一格都是真的。
下面这些数字取自生产库(2026-11-21)。不写增长曲线,因为真正值得看的是:有 440 个人愿意把稿子交给它试一次。
说清楚一件事:这波增长主要来自一位合作方的渠道(他带来了大部分注册与成交,按 50% 分成), 不是我自己的内容带来的。产品验证了「有人愿意为它付钱」,还没验证「我能稳定地把它卖出去」—— 后者是接下来要解决的问题,不是这一页要吹的部分。